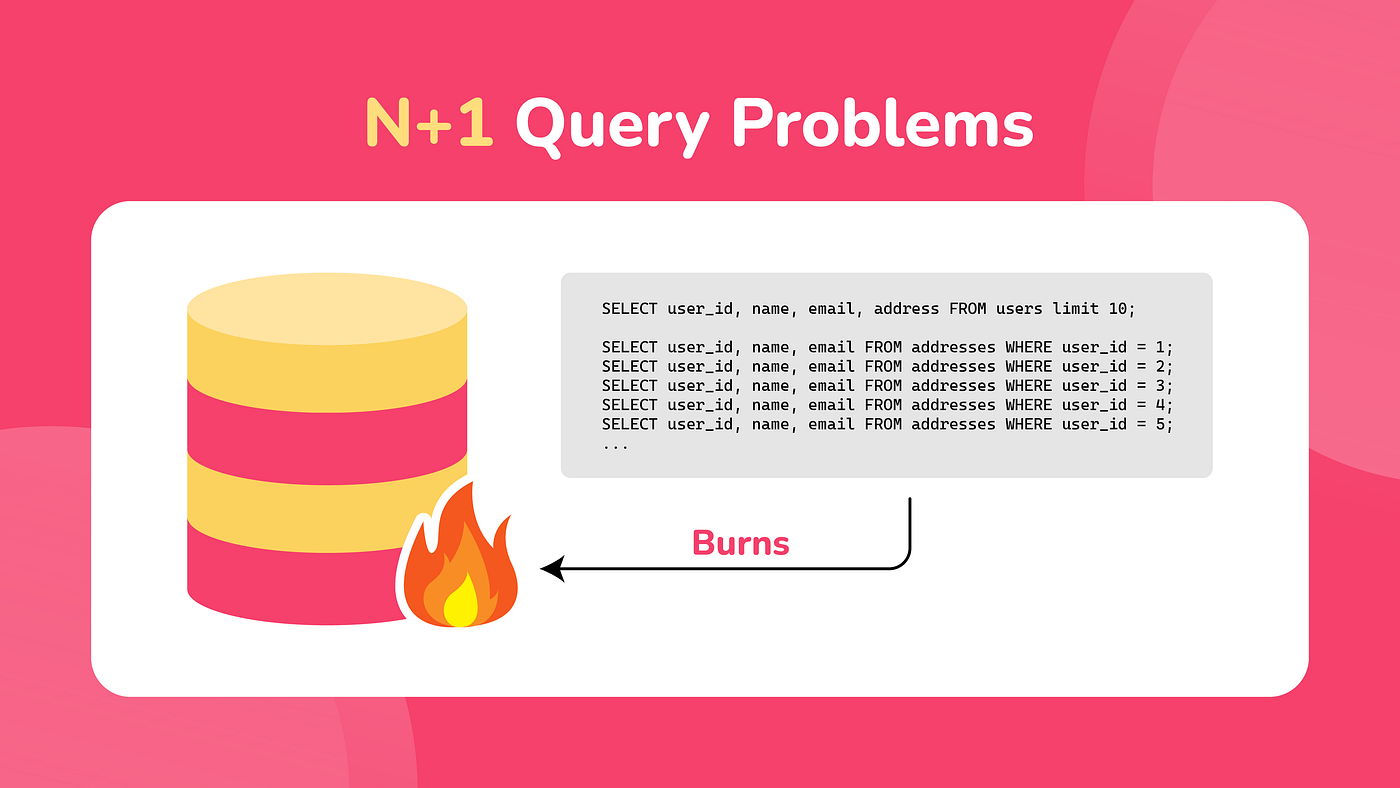
Ton application marche bien en développement, tu la mets en production, les données arrivent et une page qui répondait en cinquante millisecondes en prend maintenant quatre mille. Rien n'a changé dans le code, le coupable est presque toujours le même. C'est le problème N+1.
C'est le défaut de performance le plus répandu dès qu'on utilise un ORM. C'est aussi l'un des plus faciles à corriger. Encore faut-il savoir le repérer.
Ce qu'est le problème N+1
Le nom vient du nombre de requêtes envoyées à la base. Une requête pour récupérer une liste de N éléments puis une requête de plus par élément pour charger une donnée liée. Total N + 1.
Un exemple en Laravel.
$articles = Article::all();

foreach ($articles as $article) {
    echo $article->author->name;
}
Trois lignes qui ont l'air de rien mais voilà ce qui part vraiment vers la base.
SELECT * FROM articles;

SELECT * FROM users WHERE id = 1;
SELECT * FROM users WHERE id = 2;
SELECT * FROM users WHERE id = 3;
-- et ainsi de suite
Avec dix articles, onze requêtes. Avec mille articles, mille et une.
Le piège est là ! En développement, ta base contient dix lignes de test, la page répond du tac au tac, le défaut est invisible et il ne se montre que quand le volume monte. Donc en production.
Pourquoi les ORM produisent ce défaut
Ce n'est pas un bug. C'est la conséquence directe du chargement paresseux. Un mécanisme voulu.
Un ORM ne peut pas deviner ce dont tu auras besoin. S'il chargeait toutes les relations à chaque fois, la moindre requête ramènerait la moitié de la base. Il charge donc l'objet principal puis il attend que tu demandes une relation pour aller la chercher.
$article = Article::find(1);
// Une requête sur articles

$article->author;
// Deuxième requête, déclenchée par cet accès
Sur un objet seul, ce comportement est bon. Dans une boucle, il devient un problème. Chaque tour déclenche son propre aller-retour vers la base.
Le coût réel n'est d'ailleurs pas le temps d'exécution SQL. Chaque requête coûte un aller-retour réseau, une analyse par le moteur et un passage dans la couche de connexion. Sur une base distante, un millième de seconde par requête devient une seconde entière au bout de mille tours.
Le détecter avant la production
En Laravel
Le moyen le plus direct consiste à faire lever une erreur dès qu'une relation est chargée à la volée.
// Dans AppServiceProvider::boot()
Model::preventLazyLoading(!app()->isProduction());
Hors production, toute relation non préchargée lève une LazyLoadingViolationException. C'est brutal mais efficace. Tu ne peux plus laisser passer le défaut.
Si tu préfères une version qui ne casse pas la page, journalise au lieu de lever une exception.
Model::preventLazyLoading(!app()->isProduction());

Model::handleLazyLoadingViolationUsing(function (Model $model, string $relation) {
    Log::warning('Relation chargée à la volée : ' . $model::class . '::' . $relation);
});
Tu ouvres ensuite storage/logs/laravel.log, tu vois exactement où sont tes N+1.
Pour observer le trafic SQL réel :
DB::listen(function ($query) {
    Log::debug($query->sql, ['temps' => $query->time]);
});
Laravel Debugbar et Telescope affichent aussi le compte de requêtes par page avec les doublons signalés.
En Spring Boot et Hibernate
Active les statistiques d'Hibernate.
spring.jpa.properties.hibernate.generate_statistics=true
logging.level.org.hibernate.stat=DEBUG
À chaque transaction, Hibernate affiche le nombre de requêtes préparées et le temps passé. Un écart entre le nombre d'entités et le nombre de requêtes saute aux yeux.
Pour voir le SQL lisible :
spring.jpa.show-sql=true
spring.jpa.properties.hibernate.format_sql=true
Ne laisse jamais ces options actives en production car le volume de logs serait ingérable.
La bibliothèque datasource-proxy va plus loin. Elle permet de faire échouer un test au-delà d'un certain nombre de requêtes. C'est le meilleur moyen d'empêcher un retour en arrière.
Corriger en Laravel
Le préchargement
La solution de base est with().
$articles = Article::with('author')->get();

foreach ($articles as $article) {
    echo $article->author->name;
}
Deux requêtes, quel que soit le nombre d'articles.
SELECT * FROM articles;
SELECT * FROM users WHERE id IN (1, 2, 3, 4, 5);
Eloquent collecte les identifiants, il fait une seule requête avec in puis il rattache les résultats en mémoire.
Les relations imbriquées
// Article, son auteur, ses commentaires et l'auteur de chaque commentaire
$articles = Article::with('author', 'comments.user')->get();
Limiter les colonnes
Charger toute la ligne pour n'afficher qu'un nom est du gaspillage.
$articles = Article::with('author:id, name, avatar')->get();
Attention au piège. La clé étrangère doit toujours figurer dans la liste. Sans id ici, Eloquent ne peut pas rattacher l'auteur à l'article, la relation revient vide sans aucune erreur.
Compter sans charger
Pour afficher le nombre de commentaires, ne charge pas les commentaires.
// Mauvais : charge tous les commentaires pour les compter
$articles = Article::with('comments')->get();
$count = $article->comments->count();

// Bon : le comptage est fait par la base
$articles = Article::withCount('comments')->get();
$count = $article->comments_count;
withCount ajoute une sous-requête à la requête principale. Aucun objet inutile n'est construit côté PHP.
Les mêmes variantes existent pour les agrégats.
$articles = Article::withSum('comments', 'score')
    ->withAvg('ratings', 'value')
    ->withExists('comments')
    ->get();
Le préchargement conditionnel
$articles = Article::with(['comments' => function ($query) {
    $query->where('is_approved', true)
        ->latest()
        ->limit(5);
}])->get();
Charger après coup
Quand la collection existe déjà.
$articles = Article::all();

// Selon le contexte
if ($needsAuthors) {
    $articles->load('author');
}
loadMissing() fait la même chose en ignorant les relations déjà chargées.
Le préchargement par défaut
Si une relation est nécessaire dans quasiment tous les cas.
class Comment extends Model
{
    protected $with = ['user'];
}
À manier avec prudence. Une relation chargée à chaque fois alourdit toutes les requêtes y compris celles qui n'en ont pas besoin. Garde ça pour les relations vraiment indispensables.
Corriger en JPA et Hibernate
Le principe est le même, les outils diffèrent.
Le piège des valeurs par défaut
Point capital et souvent ignoré. JPA n'a pas le même comportement par défaut selon le type de relation.
| Annotation | Chargement par défaut |
|---|---|
@OneToMany |
LAZY |
@ManyToMany |
LAZY |
@ManyToOne |
EAGER |
@OneToOne |
EAGER |
Les deux dernières lignes posent problème, un @ManyToOne en EAGER veut dire que charger une entité charge aussi son parent à chaque fois même quand tu n'en as pas besoin. Sur une entité qui a plusieurs relations @ManyToOne, une seule lecture peut déclencher une cascade de jointures.
Tout le monde recommande la même chose, mets tout en LAZY puis charge explicitement ce dont tu as besoin.
@Entity
public class Article {

    @ManyToOne(fetch = FetchType.LAZY)
    @JoinColumn(name = "author_id")
    private User author;

    @OneToMany(mappedBy = "article", fetch = FetchType.LAZY)
    private List<Comment> comments;
}
JOIN FETCH
L'équivalent direct du with() de Laravel.
@Query("""
    SELECT a FROM Article a
    JOIN FETCH a.author
    WHERE a.publishedAt IS NOT NULL
    """)
List<Article> findPublishedWithAuthor();
Attention à la différence entre join et join fetch. Un join simple sert à filtrer, il ne charge pas la relation. Seul join fetch la ramène en mémoire.
Les graphes d'entités
Plus souples, ils séparent la requête de la stratégie de chargement.
@Entity
@NamedEntityGraph(
    name = "Article.withAuthorAndComments",
    attributeNodes = {
        @NamedAttributeNode("author"),
        @NamedAttributeNode("comments")
    }
)
public class Article { }
public interface ArticleRepository extends JpaRepository<Article, Long> {

    @EntityGraph(value = "Article.withAuthorAndComments")
    List<Article> findByPublishedAtIsNotNull();
}
L'avantage est net, la même méthode peut avoir plusieurs stratégies de chargement selon le besoin sans dupliquer la requête.
Le chargement par lots
Solution intermédiaire, très efficace et souvent oubliée.
spring.jpa.properties.hibernate.default_batch_fetch_size=25
Hibernate regroupe alors les chargements paresseux par paquet. Au lieu de cent requêtes, il en envoie quatre avec un in de vingt-cinq identifiants. On ne passe pas de N+1 à 1, on passe de N+1 à N/25 + 1. Ça suffit largement dans la plupart des cas.
L'annotation @BatchSize permet le même réglage relation par relation.
Les projections DTO
La solution la plus performante quand tu n'as besoin que de lire.
public record ArticleSummary(Long id, String title, String authorName) { }
@Query("""
    SELECT new com.blog.dto.ArticleSummary(a.id, a.title, a.author.name)
    FROM Article a
    """)
List<ArticleSummary> findAllSummaries();
Une seule requête et seulement les colonnes utiles. Aucune entité gérée par le contexte de persistance. Pour une page de liste en lecture seule, c'est souvent le meilleur choix.
Les pièges spécifiques à Hibernate
Trois erreurs classiques qui surprennent tout le monde une fois.
MultipleBagFetchException
// Lève une exception au démarrage
@Query("""
    SELECT a FROM Article a
    JOIN FETCH a.comments
    JOIN FETCH a.tags
    """)
Hibernate refuse de charger deux collections de type List dans la même requête. Le message est clair, la cause l'est moins. Une List sans index garde les doublons. Deux jointures donneraient un résultat ambigu.
Trois solutions : remplacer List par Set, faire deux requêtes séparées (le contexte de persistance rassemble les résultats tout seul) ou poser @BatchSize sur la seconde collection.
Le produit cartésien
Même avec des Set, deux join fetch sur des collections donnent un produit cartésien en base. Un article avec vingt commentaires et cinq tags renvoie cent lignes SQL. Hibernate déduplique en mémoire mais les cent lignes ont bien traversé le réseau.
En pratique, une seule collection par requête. Les autres passent par @BatchSize ou une requête séparée.
Pagination et JOIN FETCH
L'avertissement HHH000104 est le plus dangereux de tous parce que le code marche quand même.
@Query("SELECT a FROM Article a JOIN FETCH a.comments")
Page<Article> findAll(Pageable pageable);
Hibernate ne peut pas appliquer limit en SQL. La jointure multiplie les lignes et une limite couperait des collections au milieu. Il charge donc toute la table puis il pagine en mémoire Java.
Sur mille articles, ta page de vingt éléments en charge mille. Aucune erreur, juste une application qui s'écroule dès que le volume monte.
La solution consiste à découper en deux temps.
// 1. Récupérer les identifiants de la page sans jointure
@Query("SELECT a.id FROM Article a ORDER BY a.publishedAt DESC")
Page<Long> findPageOfIds(Pageable pageable);

// 2. Charger ces entités avec leurs collections
@Query("SELECT a FROM Article a JOIN FETCH a.comments WHERE a.id IN :ids")
List<Article> findAllWithCommentsByIds(@Param("ids") List<Long> ids);
L'excès inverse
Corriger un N+1 ne veut pas dire tout précharger.
// Coûteux et probablement inutile
$articles = Article::with([
    'author.profile.settings',
    'comments.user.roles',
    'tags',
    'category.parent',
])->paginate(15);
Si ta vue n'affiche que le titre et le nom de l'auteur, tout le reste est du transfert et de la mémoire jetés par la fenêtre. Une seule grosse requête peut être plus lente que quelques petites.
La règle tient en une phrase, précharge exactement ce que la vue consomme pas ce dont elle pourrait avoir besoin un jour. Le préchargement répond à un besoin constaté. Ce n'est pas une précaution.
Une méthode de travail
Quatre étapes dans cet ordre.
Mesure d'abord : Compte le nombre de requêtes de ta page. En Laravel, Debugbar l'affiche. En Spring, les statistiques Hibernate le donnent. Sans mesure, tu optimises à l'aveugle.
Rends le défaut visible : preventLazyLoading en Laravel, un seuil de requêtes dans les tests en Spring. Un défaut que l'outil signale ne peut plus revenir en douce.
Corrige au bon endroit : Le préchargement se déclare dans le contrôleur ou dans le dépôt, jamais dans la vue. Une vue ne devrait jamais déclencher de requête.
Vérifie après : Recompte. Passer de cent une à deux requêtes ça se constate, ça ne se suppose pas.
Commentaires (0)
Laisser un commentaire
Vous pouvez commenter en renseignant votre nom et votre email. Votre message sera publié après modération. Avec un compte, il apparaît immédiatement et reste modifiable.
Aucun commentaire pour le moment
Soyez le premier à commenter cet article !